NOTAS DE DESARROLLO
Modo Ultrafast: mide la tarea completa antes de pagar por más velocidad
Una novedad de octubre de 2026 puesta a prueba con latencia y costos completos.
Documentación revisada el 14 de octubre de 2026. Esta guía analiza la versión fechada que se describe a continuación; consulta la documentación oficial enlazada para confirmar el comportamiento actual de la API y la disponibilidad de tu cuenta antes de implementarla.
El texto rápido se siente bien. También puede esconder que tu aplicación pasa casi todo el tiempo esperando otra cosa. OpenAI añadió Ultrafast para GPT-6.1 Sol el 8 de octubre de 2026. La guía oficial explica el modo y el historial confirma la fecha. Así lo evaluaría antes de aumentar el presupuesto.
Divide la espera
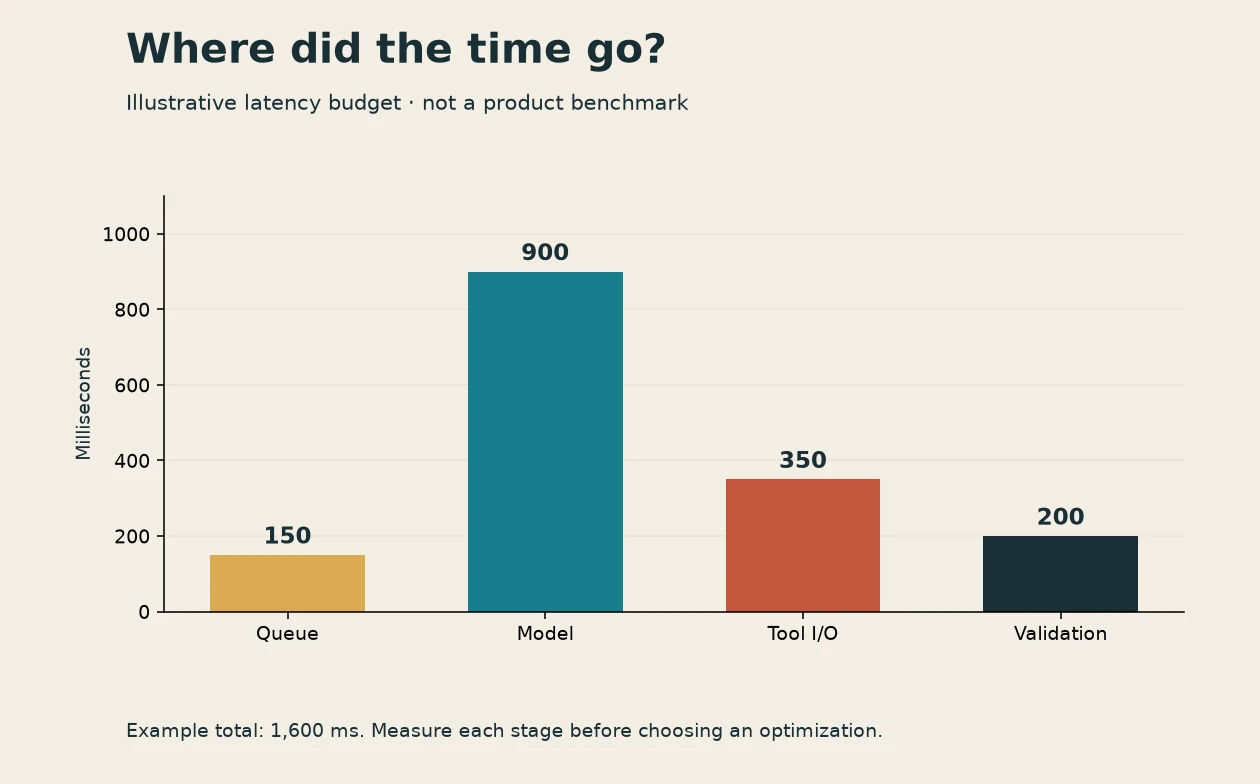
Separa cola, modelo, herramientas, validación y entrega. Si una consulta tarda ocho segundos y generar texto tarda dos, eliminar la generación dejaría casi toda la espera. Es un ejemplo hipotético, no una medición de proveedores ni de ProgreTech.
Mide por separado el primer resultado útil y la tarea completa. Ver aparecer texto temprano no garantiza tener una respuesta utilizable temprano. Las herramientas externas pueden seguir siendo el cuello de botella.
Cambia una sola cosa
Usa solicitudes saneadas con salidas de varios tamaños. Conserva modelo, esfuerzo, herramientas e instrucciones. En Responses el ajuste documentado es service_tier: "ultrafast". Compara con tu configuración base y registra la información efectiva del servicio cuando esté disponible. Consulta precios y elegibilidad vigentes.
Repite pruebas, alterna el orden y distingue solicitudes frías de calientes. Publica mediana, percentil de cola y tamaño de muestra. Diez llamadas sirven para detectar una integración rota, no para caracterizar todas las horas de demanda. Conserva fallos y reintentos.
Paga por tiempo útil
Calcula costo por resultado aceptado, incluyendo modelo, herramientas, reintentos y revisión. Reducir segundos en programación interactiva puede valer la pena. Una clasificación nocturna quizá necesite mejor rendimiento por lote, no menor espera individual.
Tu tabla puede incluir configuración, tareas aceptadas, intentos, duración mediana, p95 y costo total. Deja vacías las cifras no medidas. Si un gráfico usa números hipotéticos, indícalo dentro de la figura.
Conserva una alternativa
Mantén una ruta normal cuando la rápida falle o deje de compensar. Limita reintentos y permite cancelar. Un timeout del modelo no autoriza repetir una herramienta que modifica estado. Revisión: 14 de octubre de 2026; este artículo no aporta benchmarks propios. La meta es saber qué espera estás pagando por reducir.
Ultrafastはタスク全体の時間で判断する
この記事は2026年10月14日に確認した資料に基づく。以下で紹介するのは、その日付の公開情報だ。実装前に、リンク先の公式資料で現在のAPI仕様とアカウントの利用条件を確認してほしい。
速く文字が出ても、タスク全体が速いとは限らない。GPT-6.1 SolのUltrafast対応は2026年10月8日の更新だ。公式説明を10月14日に確認した。この記事には独自の速度実測はない。
待ち時間を分解する
待ち行列、モデル、ツール、検証、結果表示を分ける。仮にDBが8秒、文章生成が2秒なら、生成をゼロにしても多くの待ち時間は残る。これは説明用の数字だ。最初の有用な出力と、利用可能な最終結果の時間を別々に測る。
一つだけ変える
機密情報を除いた短文・中文・長文の依頼を用意する。モデル、推論量、ツール、指示を固定し、Responsesのservice_tier: "ultrafast"を比較する。現在の料金と利用条件を確認し、有効な設定も記録する。順番を変えて繰り返し、冷えた起動と温まった処理を分ける。中央値、p95、標本数、失敗、再試行を残す。少数の成功だけで混雑時まで語らない。
合格した結果の費用で判断する
モデル、ツール、再試行、人の確認を含む費用を、受け入れたタスク数で割る。対話中の数秒と夜間一括処理の数秒では価値が違う。表には設定、合格数、試行数、中央値、p95、総費用を置き、未測定欄を想像で埋めない。説明用グラフなら図中にも架空と記す。
高速経路が使えない場合の通常経路、再試行上限、キャンセルを用意する。生成が時間切れでも、状態を変える操作を無条件に再実行しない。どの待ち時間にお金を払うか分かる実験にしよう。
Pon esta idea en práctica
Sigue leyendo
Migrar a GPT-6.1 Sol: revisa la solicitud antes de juzgar el modelo
Convierte el cambio de septiembre de 2026 en una migración pequeña y medible.
Decisions API, beta de octubre de 2026: un clasificador que sabe cuándo derivar
Diseña clasificación tipada, abstención, errores y evaluación tras la beta de octubre de 2026.
Controles de claves de septiembre: rota accesos sin romper tus workers
Introduce caducidad y políticas de creación teniendo en cuenta las claves existentes.