NOTAS DE DESARROLLO
Una evaluación de código con IA debe detectar el fallo, no admirar la respuesta
Crea evaluaciones con casos reservados, comprobaciones independientes e intentos bien contados.
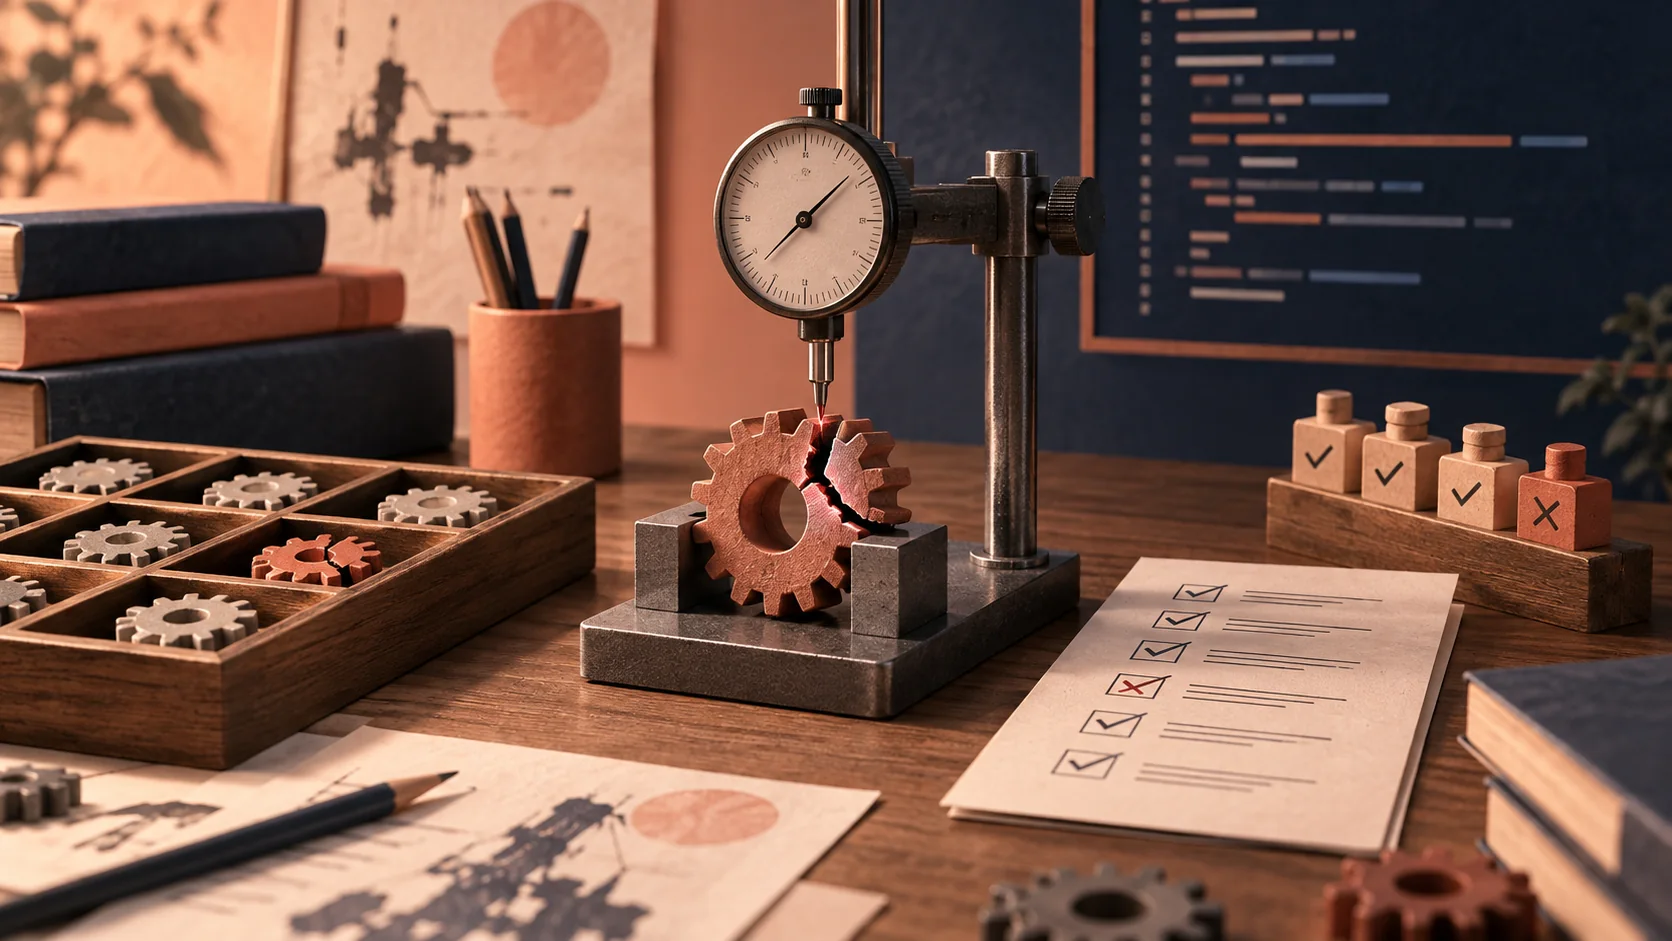
Una explicación convincente puede hacer que un parche incorrecto parezca terminado. Por eso prefiero que la aplicación tenga voto en la evaluación. El agente puede explicar, pero el comportamiento necesita evidencia independiente. Esto es una receta práctica, no un ranking de modelos.
Empieza por fallos relevantes
Elige tareas pequeñas reales: límite de importación, permisos, zona horaria, estado vacío y consulta costosa. Guarda fixtures saneados y comportamiento esperado. Incluye un caso donde falte información y la respuesta correcta sea reconocerlo.
Comprueba que el fallo existe antes. Una prueba que ya pasa no demuestra reparación. Reserva algunas comprobaciones fuera del prompt para evitar que el agente copie una aserción visible. Deben seguir siendo justas y derivarse del requisito.
Fija el contrato
Registra revisión, entorno, tarea, modelo, herramientas y timeout. Mantén el evaluador fuera de archivos que el trabajador pueda editar libremente. Si modificar pruebas forma parte del encargo, conserva otra comprobación independiente. Borrar la aserción que falla no debe convertirse en éxito.
Evalúa por separado comportamiento, regresiones, límites de permisos, alcance y evidencia. Un promedio puede esconder un problema grave. Un resultado correcto que expone un secreto no aprueba.
Cuenta los intentos
Distingue primer intento de éxito tras feedback. Incluye reintentos y reparación humana en costo y tiempo. Si alguien proporciona el algoritmo faltante, regístralo. La ayuda puede ser útil sin fingir independencia total.
Repite cuando importe la variabilidad y conserva los fallos. Una prueba inestable o caída del entorno requiere otra categoría; no la conviertas automáticamente en defecto del modelo. Publica el denominador real.
Aprende del fallo que escapó
Añade la reproducción mínima después de un incidente. Mantén un conjunto suficientemente pequeño para repetirlo al cambiar modelo, harness o dependencias, y renueva algunos casos reservados.
Un buen informe permite inspeccionar entrada, parche y comprobación. La explicación agradable ayuda; el comportamiento repetible demuestra si el asistente mejora el trabajo.
AIコード評価は説明より不具合を確かめる
説得力のある説明でも、修正が正しいとは限らない。AIのコード評価では、実際の動作に発言権を持たせたい。これはモデル順位ではなく、小さな評価セットの作り方だ。
現実の失敗を選ぶ
入力境界、権限、時差、空状態、遅い問い合わせなどの小さな課題を選ぶ。匿名化した入力と期待動作を用意し、情報不足を認めるべき課題も入れる。修正前に失敗することを確認する。最初から成功するテストでは修理を証明できない。
要求から分かる公平な確認を一部非公開にする。基点コミット、環境、依頼、モデル、ツール、時間上限を固定する。評価側の検査を自由に変更できる場所に置かない。テスト変更が課題でも独立した受け入れ検査を残す。
成功を分けて数える
必要動作、無関係な回帰、権限、差分範囲、証拠を別々に採点する。秘密を漏らして正解しても合格ではない。初回成功と助言後成功を分け、再試行と人の修正の費用を含める。環境停止や不安定なテストは別に分類し、実際の試行数を示す。
逃した不具合から最小再現を追加し、モデルや実行環境を変える前に回せる大きさを保つ。一部の未使用ケースを更新し、固定問題の暗記だけにならないようにする。説明だけでなく、入力・差分・検査を他人が追える報告を目指そう。
Pon esta idea en práctica
Sigue leyendo
Un arreglo de visión en septiembre recuerda por qué guardar pruebas visuales
Evalúa OCR y razonamiento visual conservando entradas y separando modelo de preprocesamiento.
Haz un pequeño simulacro de recuperación de tu app creada con IA
Prueba un fallo controlado, mide la recuperación y escribe una guía que otra persona pueda seguir.
Dale a tu agente una tarea que se pueda terminar y revisar
Define objetivo, límites, evidencia y entrega antes de que una tarea pequeña se vuelva una reescritura.